Whisper 字幕作成ツール
v1.2.1 / 2026年9月11日更新
MP4 や MP3 を放り込むだけで、AI(OpenAI Whisper)が話している内容を聞き取り、 字幕ファイル(SRT / VTT / ASS / JSON)を書き出す Windows 用のフリーソフトです。
v1.1 からは、字幕を動画そのものに焼き込んで書き出せるようになりました。 SNS に上げても、字幕ファイルに対応していない機器で再生しても、字幕が消えません。
処理はすべて自分のパソコンの中で完結します。 クラウドの文字起こしサービスと違い、音声データを外部に送信しません。 社外秘の会議録画や、公開前の動画にも使えます。
対応:Windows 10 / 11 | NVIDIA GPU 対応(無くても動作) | 日本語対応 | 無料・商用利用可
配布ファイルは約 55 KB です。必要な部品はセットアップ時に自動で取得されます。
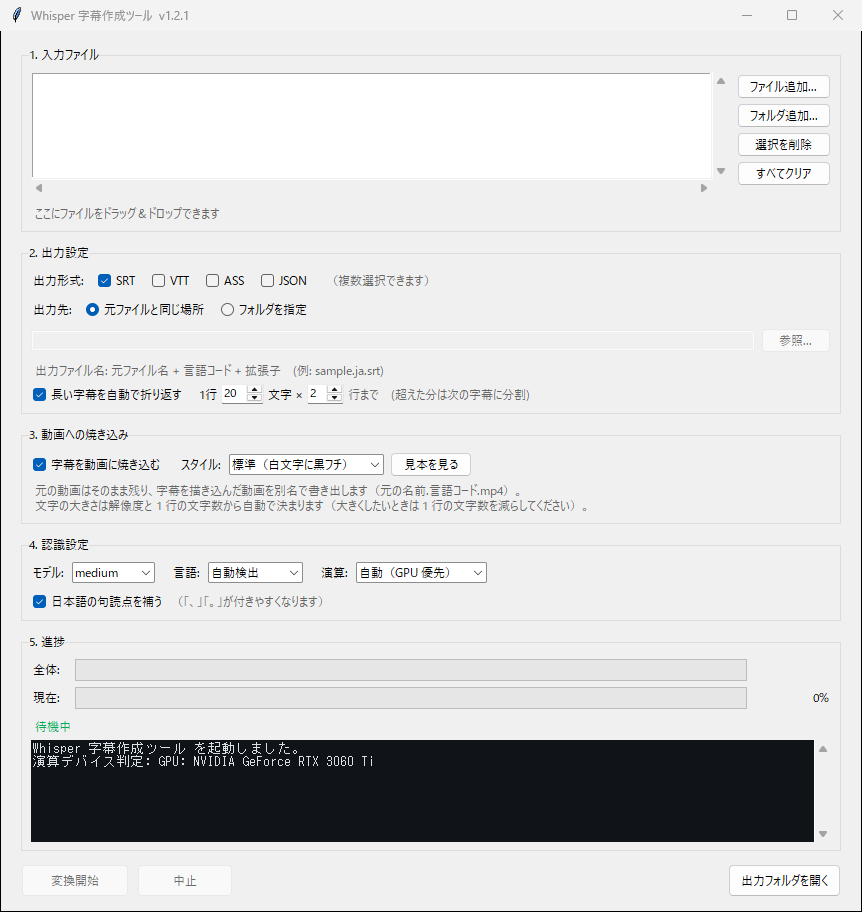
できること
- 音声を外に出さない ― 文字起こしはすべて手元のパソコンで処理します。
- 動画に字幕を焼き込む ― 字幕を描き込んだ動画を書き出せます。スタイルは 4 種類から選べます。
- GPU で高速処理 ― NVIDIA のグラフィックボードがあれば自動で使います。無い場合も CPU で動きます。
- まとめて処理 ― 複数ファイルを登録して順番に処理。フォルダごと追加、ドラッグ&ドロップも可能。
- 4 つの形式で出力 ― SRT / VTT / ASS / JSON を同時に書き出せます。ファイル名は自動生成。
- 字幕として読める形に整形 ― 指定した文字数で自動改行し、禁則処理も行います。
- 句読点を補う ― 日本語で句読点が省かれやすい問題に対応します。
- 途中で中止できる ― 長いファイルでも、間違えたと思ったら止められます。
- 削除も簡単 ― 同梱の
アンインストール.batで、設定ファイルまでまとめて削除できます。
動画への焼き込み
字幕ファイルは動画とは別のファイルなので、動画だけを SNS に上げたり、 字幕ファイルに対応していない機器で再生したりすると表示されません。 焼き込みは字幕を映像に直接描き込むので、どこで再生しても字幕が出ます。
元の動画はそのまま残り、字幕を描き込んだ動画が別の名前で作られます。
会議録画.mp4 → 会議録画.ja.mp44 つのスタイル
下の見本は、本ツールの焼き込み機能そのもので描いたものです。 背景には、明るい屋外を模した画像を使っています。
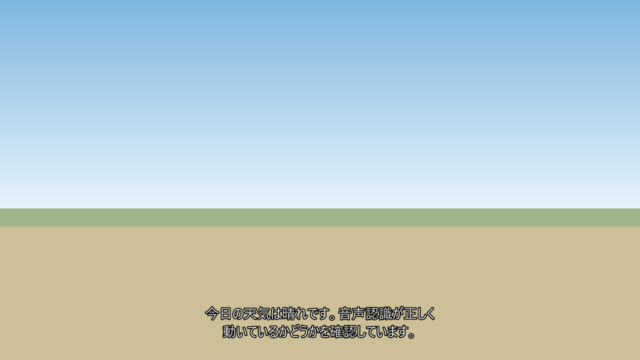
ふつうの横長の動画に。迷ったらこれ
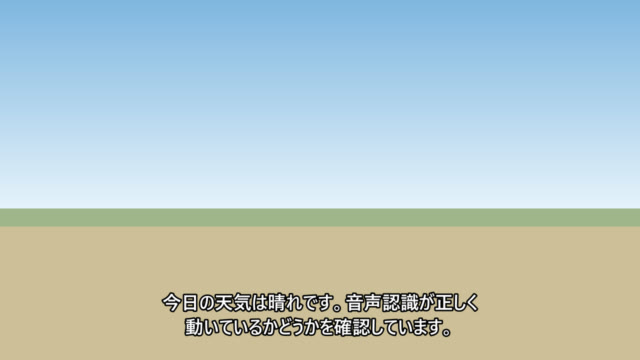
スマホで見る前提の動画に
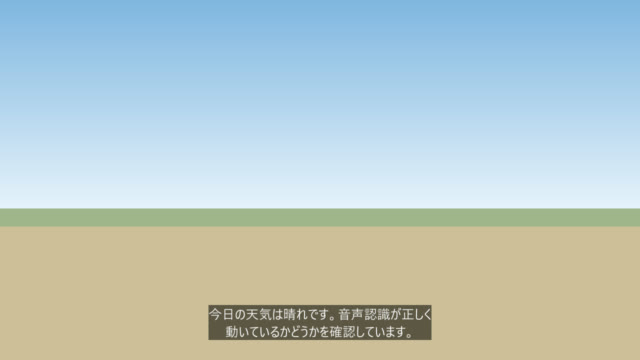
背景が明るい映像でも読める
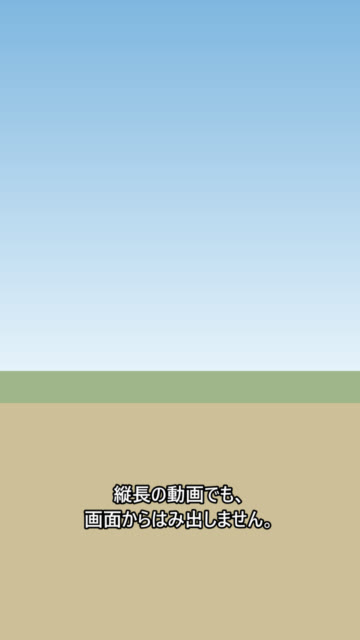
(少し上・太字)
縦長のショート動画向けです。画面下にある操作ボタンに隠れないよう、字幕を少し上に出します。
縦長の動画は横幅が狭いので、1 行の文字数が多いと文字が小さくなります。 見本は 1 行 12 文字に収まる字幕で描いています。
「見本を見る」で仕上がりを確認
「見本を見る」を押すと、追加した動画の 1 コマに字幕を描いて表示します。 スタイルを切り替えながら比べられ、実際の焼き上がりと同じ見え方で確認できます。
文字の大きさは自動
文字の大きさは、動画の解像度と 1 行の文字数から自動で決まります。 一番長い行が画面の横幅に収まる大きさを上限にしているので、横長でも縦長でも字幕がはみ出しません。 もっと大きくしたいときは、出力設定の「1行 ○ 文字」を減らしてください。
出力される字幕の例
同じ音声を、自動整形の有無で比べたものです。 AI の生の出力は 1 行が 35 文字を超えることも多く、そのままでは字幕として読めません。
整形なし(AI の生の出力)
2
00:00:05,300 --> 00:00:13,120
今日の天気は晴れです 音声認識が正しく動いているかどうかを確認しています
本ツールの出力(句読点の補完+自動改行)
2
00:00:05,280 --> 00:00:13,120
今日の天気は晴れです。音声認識が正しく
動いているかどうかを確認しています。
1 行あたりの文字数と行数は画面から変更できます。初期値は「20 文字 × 2 行」で、 これはテレビ字幕の慣習に近い設定です。指定を超えた分は次の字幕に自動で分割され、 表示時間も文字数に応じて割り振られます。
処理時間のめやす
10 分の動画を標準設定(medium モデル)で文字起こしした場合の目安です。
| 環境 | 処理時間 | 備考 |
|---|---|---|
| NVIDIA GeForce RTX 3060 Ti | 約 1〜2 分 | VRAM 8GB。動作確認に使った環境 |
| GPU なし(CPU のみ) | 約 20〜40 分 | small モデルへの変更を推奨 |
初回のみ、AI モデル(約 1.5 GB)のダウンロード時間が加わります。2 回目以降は不要です。
焼き込みを使う場合は、これとは別に動画の書き出し時間がかかります。 NVIDIA / Intel / AMD のグラフィック機能が使えれば自動で使い、CPU の場合は 10 分の動画で数分程度です。
動作環境
| OS | Windows 10 / 11(64bit) |
|---|---|
| Python | 3.10 〜 3.12 未導入の場合は 公式サイトから。「Install Now」を押すだけで、管理者権限は不要です |
| 空き容量 | GPU あり:約 6 GB / GPU なし:約 3 GB 焼き込みを使う場合は、FFmpeg のぶん約 180 MB が加わります |
| 推奨 GPU | NVIDIA 製・VRAM 5GB 以上(GeForce RTX 3060 / 4060 以上) |
| ネット接続 | 初回セットアップ時と、焼き込みを初めて使うとき(FFmpeg の取得) |
対応形式:MP4 / MKV / MOV / AVI / WebM / WMV / FLV / TS / M4V / MPG / WAV / MP3 / M4A / FLAC / OGG / OPUS / AAC / WMA / AIFF (焼き込みは動画ファイルのみ)
導入手順
- ダウンロードして展開する
ZIP を好きな場所(デスクトップなど)に展開します。 - 「セットアップ.bat」をダブルクリック
必要な部品が自動で入ります。初回のみ 10〜40 分ほどかかります。 インストール先はこのフォルダの中の.venvで、システムの設定やレジストリは変更しません。 - 「起動.bat」をダブルクリック
2 回目以降はこれだけです。
以前の版から更新する場合は、新しい ZIP を別のフォルダに展開して セットアップ.bat を実行してください。
AI モデルと設定はフォルダの外の共通の場所にあるので、そのまま引き継がれます。
古いフォルダは、動作を確認してから手で削除してください(詳しく)。
うまく動かないときは FAQ・困ったとき をご覧ください。
使用しているオープンソースソフトウェア
| 名称 | 用途 | ライセンス |
|---|---|---|
| OpenAI Whisper | 音声認識 | MIT |
| PyTorch | 機械学習の実行基盤(GPU 処理) | BSD-3-Clause |
| PyAV / FFmpeg | 動画・音声の読み込み | BSD-3-Clause / LGPL |
| FFmpeg(yt-dlp による公式ビルド) | 動画への字幕の焼き込み。初回に自動取得し、同梱はしていません | GPL v3 |
| libass | 字幕の描画(上記の FFmpeg に含まれます) | ISC |
| tkinterdnd2 | ドラッグ&ドロップ | MIT |
更新履歴
| バージョン | 日付 | 内容 |
|---|---|---|
| v1.2.1 | 2026-09-11 | 配布 ZIP にライセンス文(LICENSE)を同梱。機能の変更はありません。 |
| v1.2 | 2026-09-11 | アンインストーラ(アンインストール.bat)を同梱。
AI モデルや FFmpeg など他と共有しているものは、消すかどうかを 1 つずつ確認します。 |
| v1.1 | 2026-09-10 | 字幕を動画に焼き込む機能を追加(スタイル 4 種・見本の表示・GPU エンコード対応)。 ASS 形式の出力に対応。 |
| v1.0 | 2026-09-09 | 初回公開。SRT / VTT / JSON 出力、GPU 自動判定、複数ファイル処理、 字幕の自動改行、日本語の句読点補完、残り時間表示に対応。 |
過去のバージョンは GitHub の Releases から取得できます。
ライセンスと注意
本ツールは MIT License で公開しており(配布 ZIP にライセンス文を同梱)、無料で商用・業務利用も可能です。 内部で利用している OpenAI Whisper(MIT License)、 PyTorch(BSD-3-Clause)、 PyAV / FFmpeg のライセンスに従います。 焼き込みに使う FFmpeg(GPL)は同梱しておらず、利用者のパソコンが公式ビルドを直接取得します。